اجرای مدلهای زبانی بزرگ روی کامپیوتر شخصی با ابزارهایی مانند llama.cpp امکان استفاده از هوش مصنوعی بدون وابستگی به سرویسهای ابری را فراهم کرده است؛ اما سرعت تولید پاسخ همیشه به قدرت کارت گرافیک و حجم حافظه آن بستگی ندارد. قابلیت MTP یا Multi-Token Prediction یکی از روشهایی است که میتواند سرعت تولید متن در مدلهای خانواده Gemma 4 را به شکل چشمگیری افزایش دهد.
این قابلیت با کمک یک مدل کمکی به نام Drafter کار میکند و به مدل اصلی اجازه میدهد بهجای تولید توکنها بهصورت کاملاً متوالی، چند توکن احتمالی را همزمان بررسی کند. در نتیجه، ممکن است بدون تعویض کارت گرافیک یا کاهش حجم مدل، سرعت اجرای محلی هوش مصنوعی بیشتر شود.
قابلیت MTP در Gemma 4 چیست و چگونه سرعت هوش مصنوعی را افزایش میدهد؟
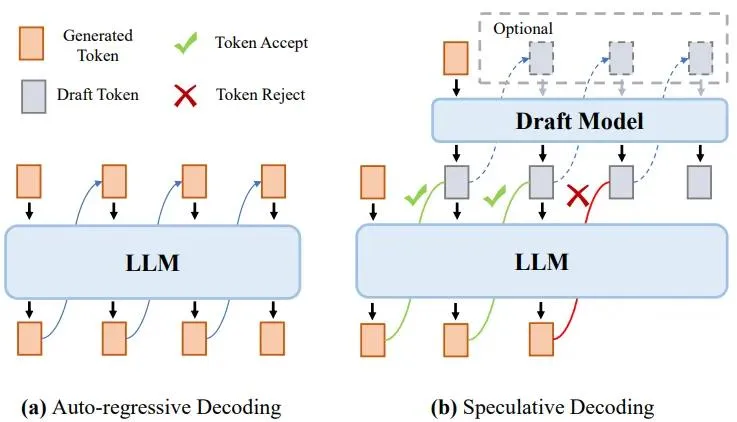
در روش معمول تولید متن، مدل زبانی هر توکن را با توجه به توکنهای قبلی پیشبینی میکند و سپس سراغ توکن بعدی میرود. این فرایند برای تولید پاسخهای طولانی به محاسبات متوالی زیادی نیاز دارد و میتواند سرعت خروجی را محدود کند.
فناوری MTP این روند را با استفاده از یک مدل کمکی یا Drafter تغییر میدهد. مدل کمکی چند توکن احتمالی را پیشبینی میکند و مدل اصلی آنها را بهصورت موازی بررسی میکند. اگر پیشبینیها درست باشند، چند توکن بدون نیاز به اجرای جداگانه مدل اصلی پذیرفته میشوند؛ در غیر این صورت مدل اصلی توکن صحیح را تولید میکند و فرایند ادامه پیدا میکند.
این روش نوعی Speculative Decoding یا رمزگشایی حدسی است. نکته مهم این است که مدل اصلی همچنان مسئول تأیید خروجی است؛ بنابراین استفاده صحیح از MTP قرار نیست دقت یا کیفیت پاسخ نهایی را کاهش دهد.
افزایش سرعت Gemma 4 با llama.cpp چقدر است؟
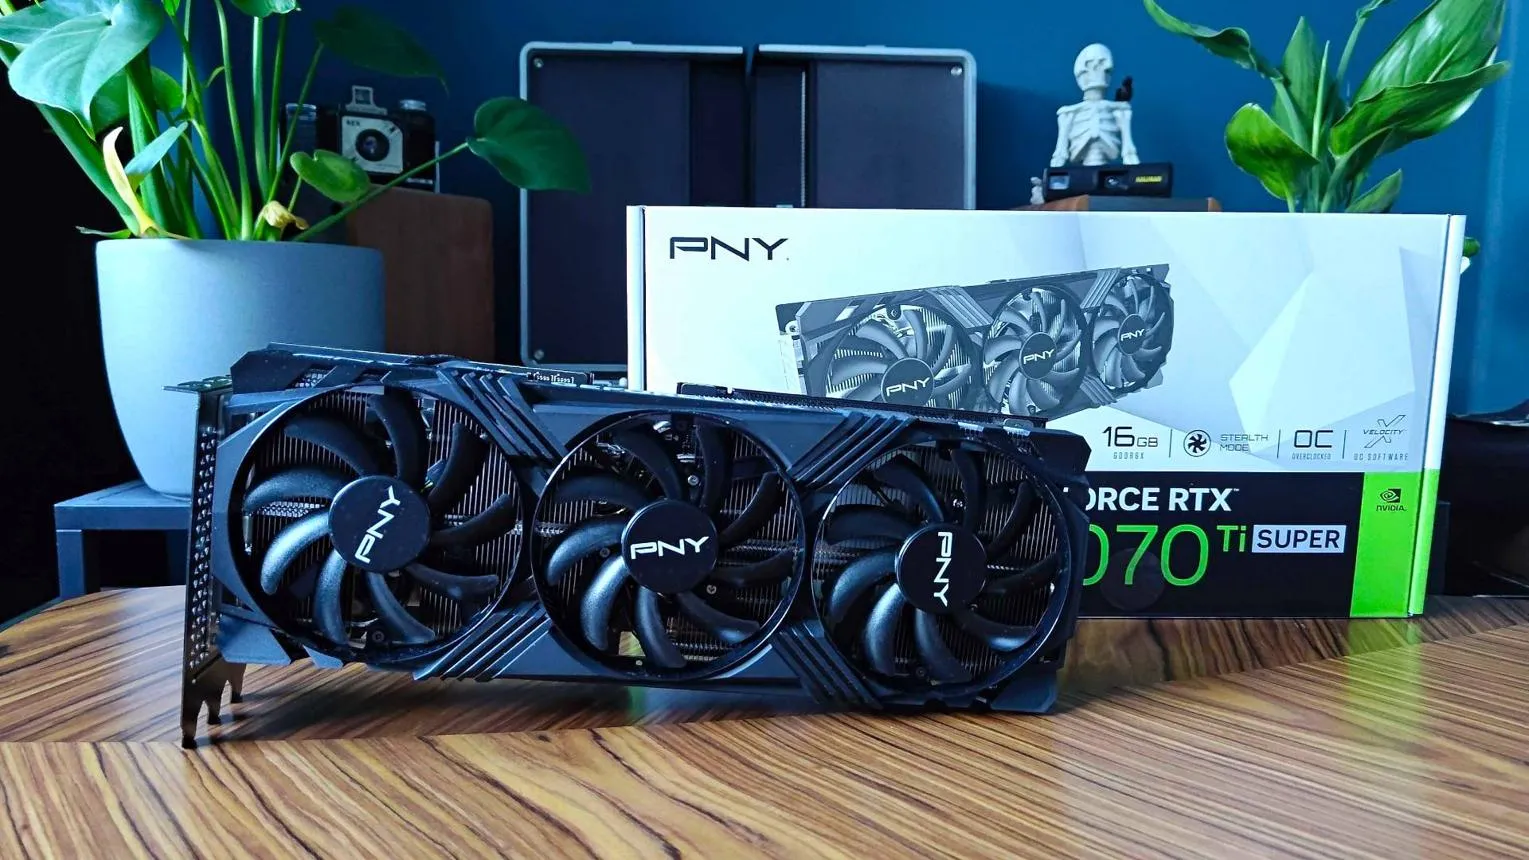
میزان افزایش سرعت به مدل انتخابشده، سختافزار، تنظیمات اجرا و نوع متنی که تولید میشود بستگی دارد. در یک آزمایش روی مدل Gemma 4 12B با کارت گرافیک RTX 4070 Ti Super و حافظه ۱۶ گیگابایتی، استفاده از MTP باعث افزایش قابلتوجه سرعت تولید متن شد.
در این آزمایش، مدل بدون MTP بهطور میانگین حدود ۷۵٫۳ توکن در ثانیه تولید میکرد؛ اما با فعالسازی مدل کمکی، میانگین سرعت به حدود ۱۷۸٫۷ توکن در ثانیه رسید. این یعنی سرعت تولید متن در مجموع حدود ۱۳۷ درصد افزایش پیدا کرد.
|
نوع آزمایش |
بدون MTP |
با MTP |
افزایش سرعت |
|---|---|---|---|
|
تولید خروجی JSON |
۷۴٫۷ |
۱۹۹٫۴ |
۱۶۷٪ |
|
تولید کد پایتون |
۷۵٫۵ |
۲۰۵٫۴ |
۱۷۲٪ |
|
تولید متن داستانی |
۷۵٫۸ |
۱۳۱٫۳ |
۷۳٪ |
|
میانگین |
۷۵٫۳ |
۱۷۸٫۷ |
۱۳۷٪ |
در این بررسی، تولید کد و خروجیهای ساختاریافته بیشترین افزایش سرعت را داشتند؛ زیرا الگوهای تکرارشونده و ساختار مشخص آنها پیشبینی توکنهای بعدی را برای مدل کمکی آسانتر میکند. تولید متن معمولی نیز سریعتر شد، اما میزان بهبود آن کمتر بود.
البته این اعداد نتیجه یک آزمایش با سختافزار و تنظیمات مشخص هستند و نباید انتظار داشت تمام سیستمها دقیقاً همین سرعت را تجربه کنند.
نحوه فعال کردن MTP در llama.cpp برای Gemma 4
برای استفاده از این قابلیت، به نسخه جدید llama.cpp و دو فایل مدل نیاز دارید: فایل اصلی Gemma 4 و فایل Drafter سازگار با همان مدل. پشتیبانی MTP در llama.cpp در ژوئن ۲۰۲۶ به پروژه اضافه شد؛ بنابراین نسخههای قدیمیتر قادر به بارگذاری این معماری نیستند.
نکته مهم این است که فایل کمکی باید با نسخه و نوع مدل اصلی سازگار باشد. به عنوان مثال، مدل QAT باید با Drafter مخصوص همان نسخه استفاده شود و نمیتوان هر فایل کمکی Gemma 4 را با هر مدل دیگری ترکیب کرد.
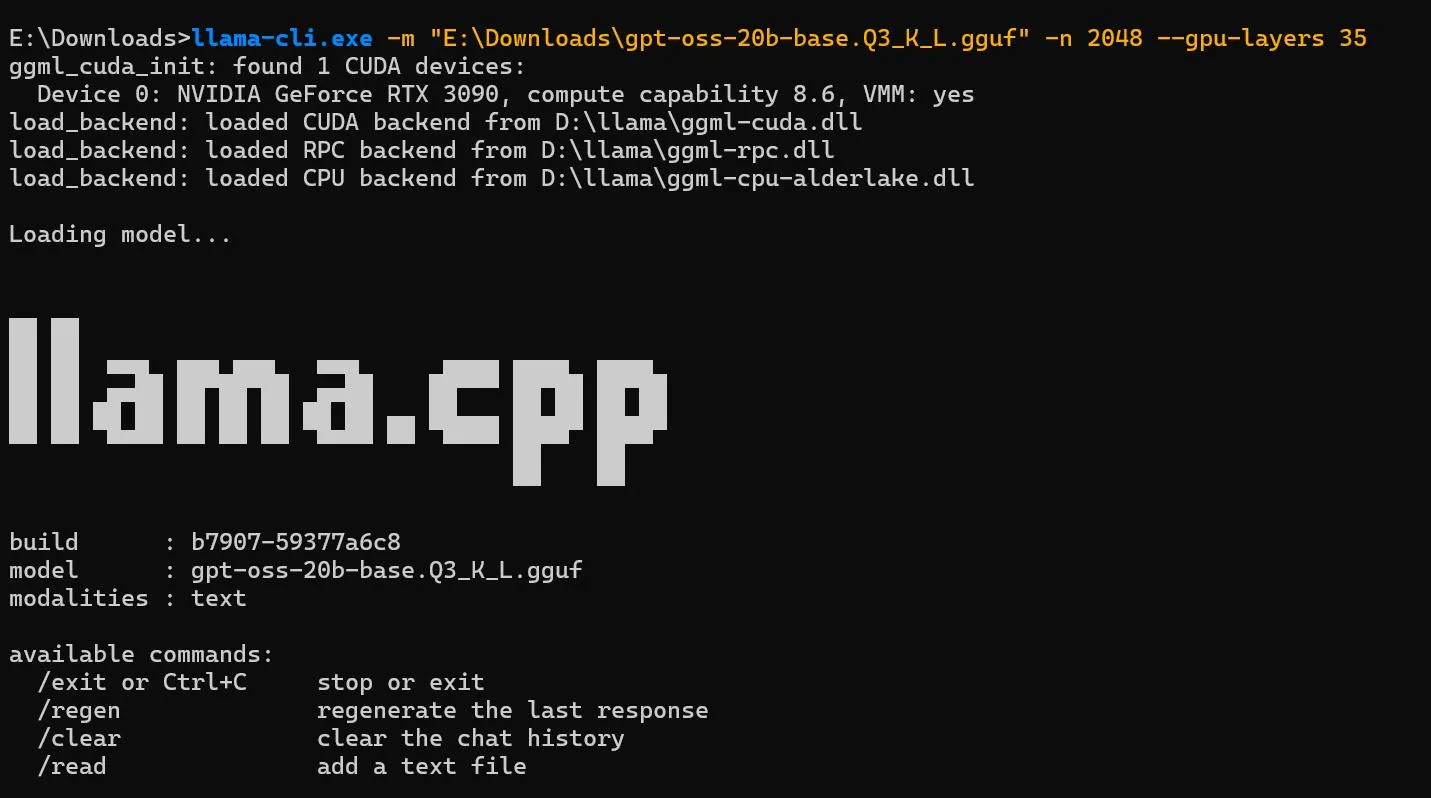
برای مدل Gemma 4 12B نسخه GGUF میتوانید از ساختار دستوری زیر استفاده کنید:
llama-server
-m gemma-4-12b-it-Q4_K_M.gguf
--model-draft MTP/gemma-4-12B-it-MTP-Q8_0.gguf
--spec-type draft-mtp
--spec-draft-n-max 4
-ngl 999
-fa on
در این دستور:
- -m فایل مدل اصلی را مشخص میکند.
- --model-draft فایل مدل کمکی MTP را بارگذاری میکند.
- --spec-type draft-mtp روش پیشبینی چندتوکنی مخصوص Gemma 4 را فعال میکند.
- --spec-draft-n-max 4 حداکثر تعداد توکنهای پیشنهادی در هر نوبت را تعیین میکند.
- -ngl 999 تلاش میکند لایههای مدل را تا حد امکان روی GPU اجرا کند.
- -fa on قابلیت Flash Attention را فعال میکند.
این دستور یک نمونه برای اجرای مدل 12B با فایلهای سازگار است؛ مقدار انتقال لایهها به GPU و تعداد توکنهای پیشنهادی باید متناسب با حافظه گرافیکی و شرایط سیستم تنظیم شود.
آیا فعال کردن MTP روی همه کارتهای گرافیک مفید است؟
خیر؛ افزایش سرعت با MTP به شرایط اجرای مدل بستگی دارد. مدل کمکی نیز برای اجرا به منابع پردازشی و حافظه نیاز دارد. اگر حافظه گرافیکی از ابتدا برای مدل اصلی و پنجره متن کافی نباشد، بارگذاری Drafter ممکن است باعث افزایش مصرف حافظه و حتی کاهش سرعت شود.
چند نکته مهم پیش از فعالسازی این قابلیت:
- از نسخه جدید llama.cpp استفاده کنید که از معماری gemma4-assistant پشتیبانی میکند.
- فایل Drafter را متناسب با نسخه مدل اصلی انتخاب کنید.
- اگر حافظه گرافیکی محدود است، تعداد لایههای منتقلشده به GPU را کاهش دهید.
- مقدار --spec-draft-n-max را آزمایش کنید؛ افزایش تعداد توکنهای پیشنهادی همیشه به معنی سرعت بیشتر نیست.
- سرعت را با چند نوع درخواست متفاوت بسنجید؛ خروجی کد، JSON و متن معمولی ممکن است نتایج متفاوتی داشته باشند.
بررسیهای انجامشده روی سختافزارهای مختلف نشان میدهند حتی کارتهای گرافیک با حافظه محدود نیز ممکن است از MTP سود ببرند؛ اما نتیجه به تنظیمات حافظه و نحوه اجرای مدل وابسته است.
سیارهی آیتی