اجرای مدلهای زبانی بزرگ بهصورت محلی فقط به تعداد پارامترهای مدل بستگی ندارد. مقدار VRAM، اندازه پنجره متنی، نوع کوانتایز و میزان لایههایی که روی کارت گرافیک اجرا میشوند، همگی روی سرعت و کاربردپذیری مدل تأثیر دارند. به همین دلیل ممکن است مدلی روی کاغذ «قابل اجرا» باشد اما در عمل بهقدری کند شود که استفاده از آن آزاردهنده باشد.
برای کارتهایی با ۸ گیگابایت VRAM، اجرای یک مدل بزرگتر همیشه بهترین راهحل نیست. یک روش کاربردی این است که بهجای تلاش برای اجرای مدل ۸B یا بزرگتر، دو مدل کوچکتر را با وظایف متفاوت اجرا کنیم. در llama.cpp میتوان چند سرور را با پورتهای متفاوت اجرا کرد و هرکدام را در یک تب مرورگر باز نگه داشت. خود llama.cpp نیز در نسخههای جدید امکان اجرای چند مدل از طریق حالت Router را فراهم کرده است.
چرا جا شدن مدل در VRAM به معنی اجرای مناسب آن نیست؟
ممکن است فایل مدل با حجم مشخصی دانلود شود و حتی با مقداری از مدل روی رم سیستم اجرا شود، اما این وضعیت الزاماً به معنی عملکرد مناسب نیست. وقتی بخشی از مدل از VRAM خارج شده و روی CPU یا رم سیستم پردازش شود، جابهجایی داده میتواند سرعت پاسخگویی را بهشدت کاهش دهد.
به عنوان مثال، یک مدل ۳۵B با کوانتایز بسیار فشرده ممکن است از نظر حجم فایل به سختافزار نزدیک باشد، اما اگر چند گیگابایت آن مجبور شود خارج از VRAM اجرا شود، مزیت معماری مدل دیگر لزوماً به سرعت بالاتر تبدیل نمیشود. همین موضوع درباره افزایش Context نیز وجود دارد؛ حتی اگر خود مدل در VRAM جا شود، KV Cache میتواند فضای باقیمانده را مصرف کند.
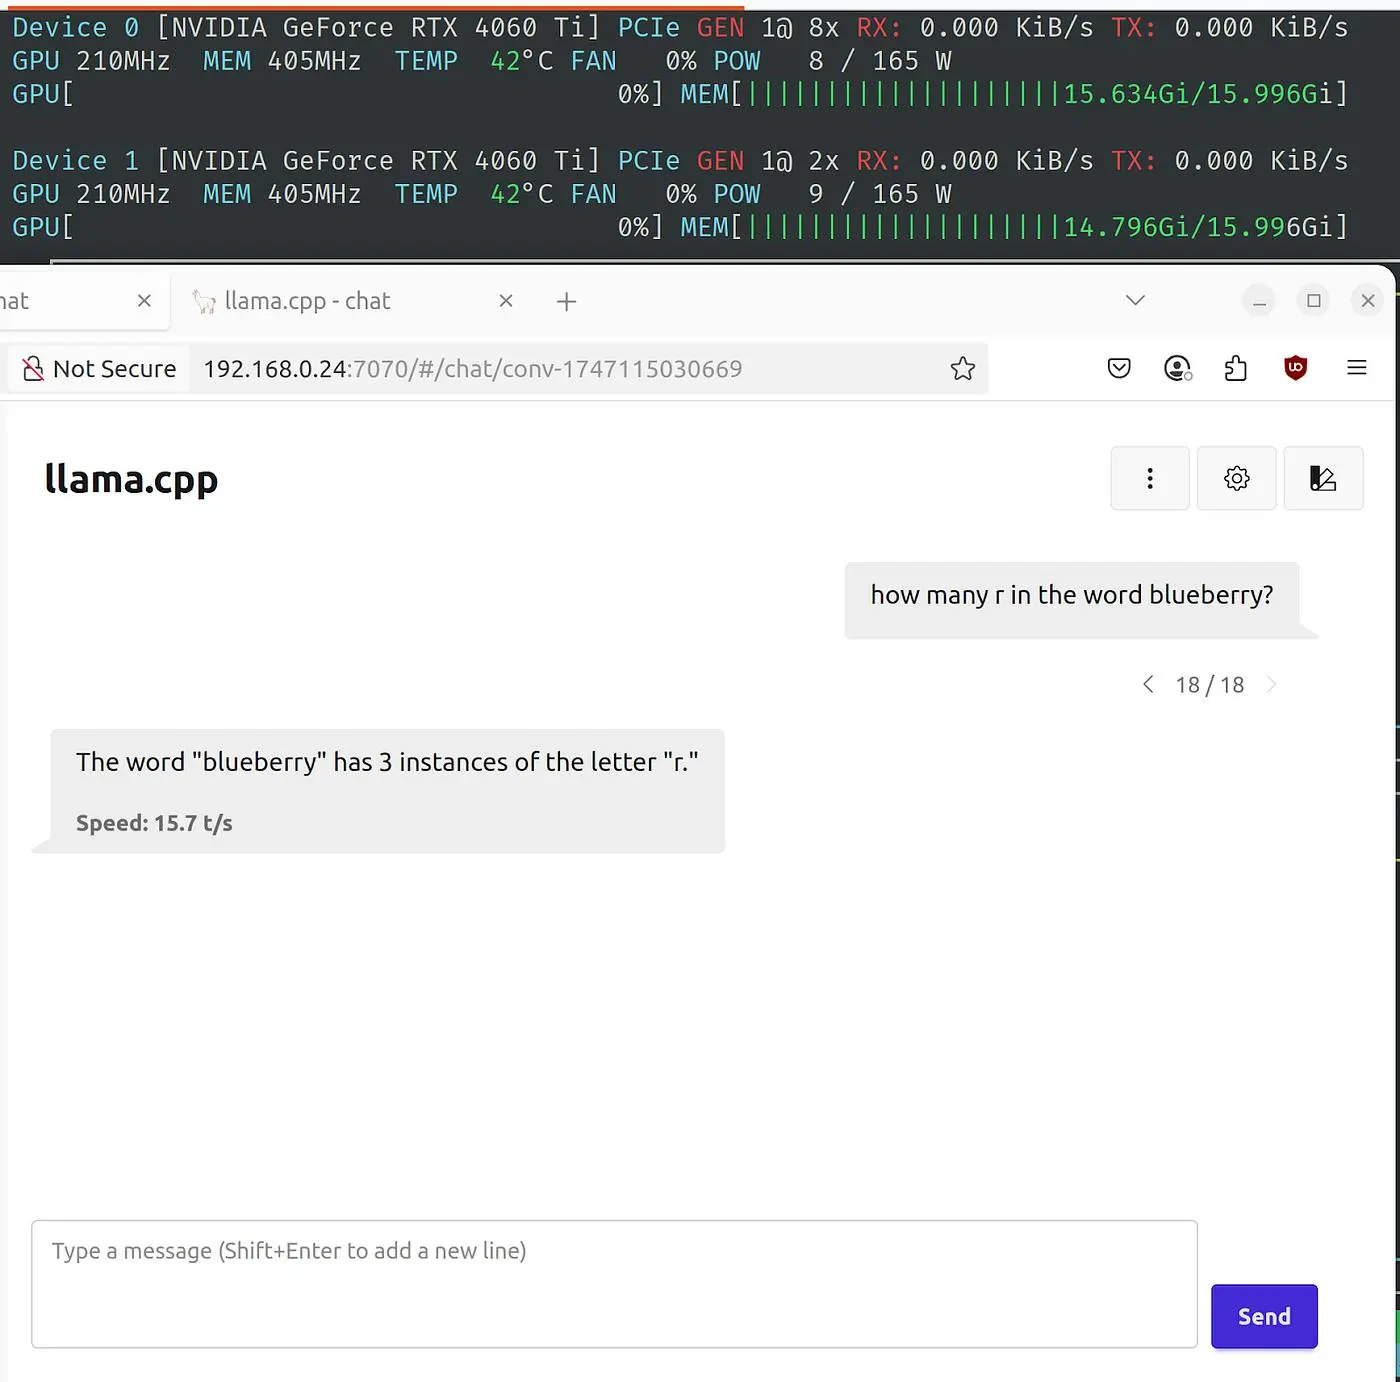
بنابراین برای یک کارت گرافیک ۸ گیگابایتی بهتر است فقط حجم فایل GGUF را بررسی نکنید. اندازه مدل، نوع کوانتایز، Context و فضای موردنیاز KV Cache را هم در نظر بگیرید. هدف اصلی باید این باشد که مدل تا حد امکان بهصورت کامل روی GPU قرار بگیرد و در هنگام استفاده دائماً به رم سیستم وابسته نباشد.
برای کارت گرافیک ۸ گیگابایتی چه مدلی منطقیتر است؟
مدلهای حدود ۲B تا ۴B معمولاً فضای بسیار بیشتری برای Context و اجرای همزمان مدلهای دیگر باقی میگذارند. برای کارهای عمومی میتوان از یک مدل کوچک مکالمهای استفاده کرد و برای کدنویسی یا پردازش ساختارهایی مانند JSON و YAML سراغ مدل تخصصیتر رفت.
به عنوان مثال، نسخه GGUF مدل Gemma 4 E2B با کوانتایز Q4_0 در مخزن رسمی گوگل ارائه شده و فایل مدل آن حدود ۳.۳۵ گیگابایت است. این مدل برای اجرای محلی با llama.cpp نیز مستقیماً پشتیبانی میشود.
اجرای دو مدل کوچک بهجای یک مدل بزرگ
ترکیب دو مدل کوچک میتواند برای سیستمهایی که VRAM محدودی دارند کاربردیتر باشد. یک مدل را میتوان برای مکالمه، پرسشهای عمومی و ترجمه نگه داشت و مدل دوم را برای کدنویسی و کارهای فنی استفاده کرد.
در یک ترکیب مشابه میتوان Gemma 4 E2B را با Q4_0 و FluentlyQwen3-Coder-4B را با Q4_K_M اجرا کرد. نسخه Q4_K_M مدل FluentlyQwen3-Coder-4B حدود ۲.۵ گیگابایت حجم دارد و این مدل یک مدل تنظیمشده توسط جامعه بر پایه Qwen3 است، نه یک مدل رسمی کدنویسی از طرف علیبابا.
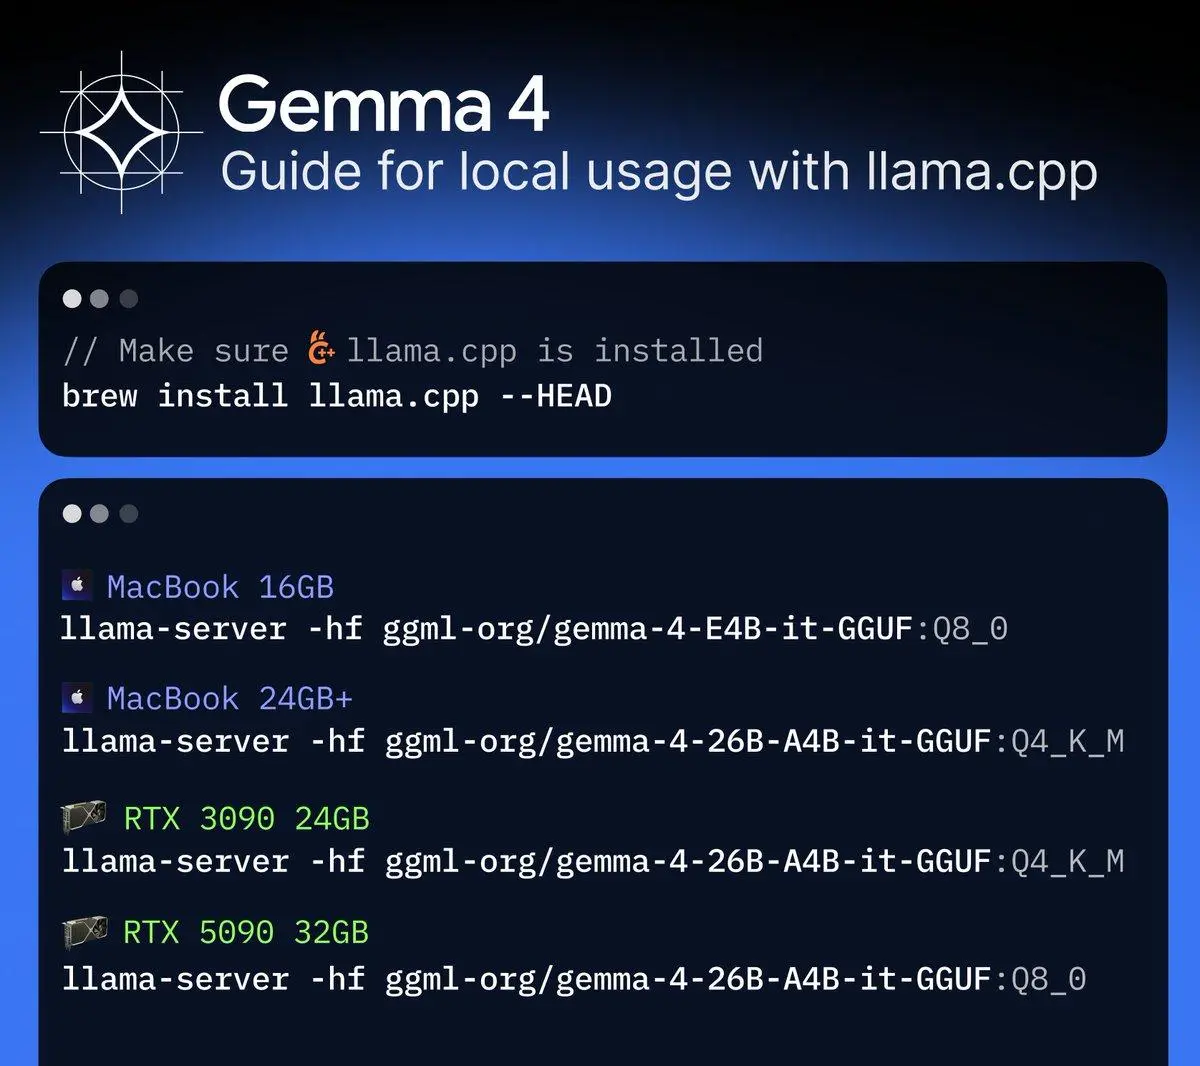
مزیت چنین ترکیبی این است که هر دو مدل میتوانند فضای نسبتاً کمی از VRAM را اشغال کنند و در صورت باقی ماندن فضای کافی، Context بیشتری نیز در اختیار داشته باشند. در نتیجه لازم نیست برای هر کار مدل را از حافظه خارج کرده و مدل دیگری را بارگذاری کنید.
کدام مدل را برای چه کاری استفاده کنیم؟
برای تقسیم وظایف میتوان چنین ساختاری داشت:
- مدل مکالمهای: پرسشهای عمومی، ترجمه، خلاصهسازی و گفتوگوی روزمره
- مدل کدنویسی: تولید و اصلاح کد، بررسی قطعهکدها و کار با JSON و YAML
- مدل کوچکتر: کارهای سریع که به Context بسیار بزرگ یا استدلال پیچیده نیاز ندارند
- مدل تخصصیتر: وظایفی که کیفیت پاسخ در یک حوزه مشخص اهمیت بیشتری دارد
این روش یک مزیت مهم دیگر هم دارد: لازم نیست یک مدل را مجبور کنید برای تمام کارها مناسب باشد. مدل کوچک مکالمهای میتواند همیشه آماده باشد و مدل تخصصیتر فقط زمانی استفاده شود که واقعاً به قابلیتهای آن نیاز دارید.
چطور دو مدل llama.cpp را همزمان اجرا کنیم؟
در روش ساده، دو نمونه جداگانه از llama-server را از همان نصب llama.cpp اجرا میکنید و برای هر مدل یک پورت متفاوت تعیین میکنید. llama.cpp بهصورت پیشفرض از پورت ۸۰۸۰ استفاده میکند و امکان تعیین پورت دلخواه با گزینه --port وجود دارد.
به عنوان مثال، ساختار کلی اجرای دو مدل میتواند به این شکل باشد:
llama-server -m model-chat.gguf --port 8080
llama-server -m model-coder.gguf --port 8081
در این حالت هر مدل آدرس جداگانهای دارد و میتوانید هرکدام را در یک تب مرورگر باز کنید. بنابراین بهجای توقف یک مدل و بارگذاری مدل دیگر، فقط بین دو تب جابهجا میشوید.
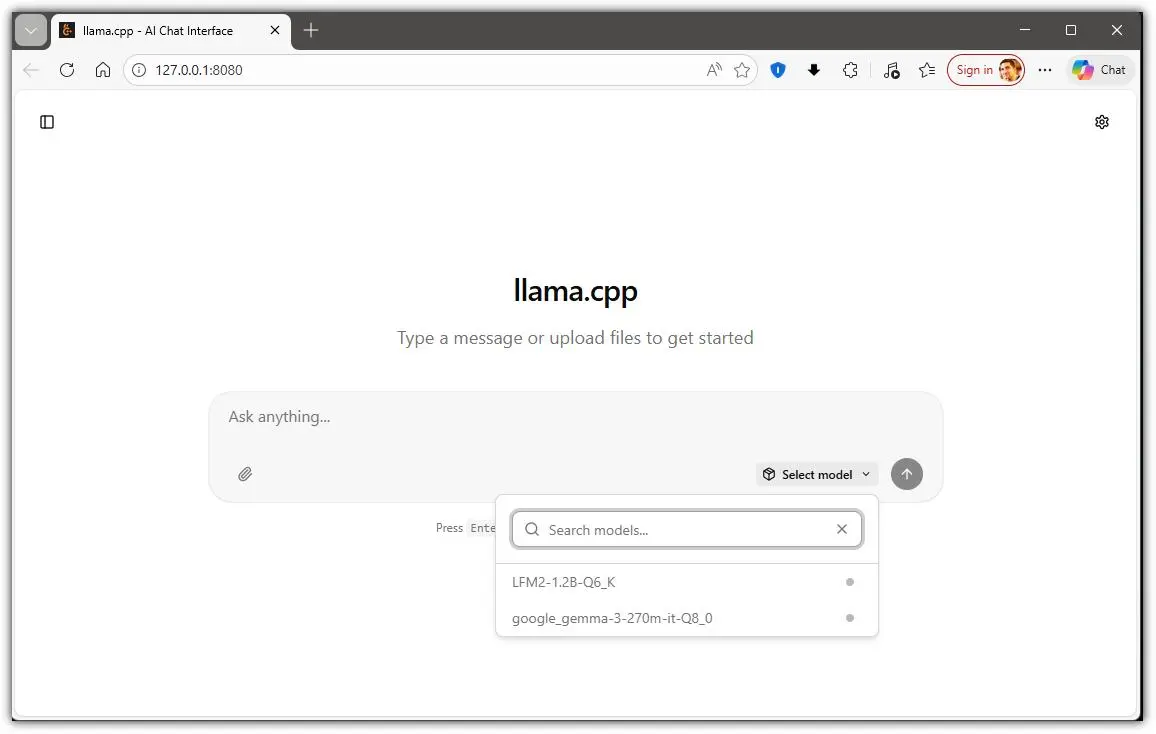
در نسخههای جدید llama.cpp یک روش دیگر نیز وجود دارد: Router. در این حالت یک llama-server میتواند مدلها را مدیریت کند و درخواستها را به نمونه مدل مناسب هدایت کند. مستندات رسمی llama.cpp همچنین امکان تعیین Context و تعداد نمونههای مدل را برای Router توضیح میدهد.
برای سیستمهای محدود، نکته مهم این است که همزمان اجرا کردن دو مدل فقط زمانی منطقی است که مجموع مصرف VRAM آنها همراه با Context و KV Cache از ظرفیت کارت گرافیک عبور نکند. بهتر است هنگام آزمایش، مصرف VRAM را با ابزارهایی مانند nvidia-smi زیر نظر داشته باشید.
تنظیم دما و پارامترهای تولید برای کارهای مختلف
پارامترهای تولید نیز میتوانند بر رفتار مدل تأثیر بگذارند. برای گفتوگو و کارهای خلاقانه معمولاً میتوان Temperature بالاتری در نظر گرفت، در حالی که برای کدنویسی مقدار پایینتر میتواند خروجی کنترلشدهتری ایجاد کند.
برای شروع میتوان حدود 0.8 برای مکالمه و حدود 0.3 برای کدنویسی را آزمایش کرد و سپس بر اساس مدل و نوع کار تغییر داد. پارامترهایی مانند Repetition Penalty و Min-P نیز بهتر است متناسب با مدل تنظیم شوند و نمیتوان یک مقدار ثابت را برای تمام مدلها مناسب دانست.
در نهایت، برای سیستم دارای ۸ گیگابایت VRAM، هدف لزوماً اجرای بزرگترین مدل ممکن نیست. گاهی دو مدل کوچک که همیشه آماده استفاده هستند، تجربهای سریعتر و کاربردیتر از یک مدل بزرگ دارند که بخشی از آن روی رم سیستم اجرا میشود.
سیارهی آیتی