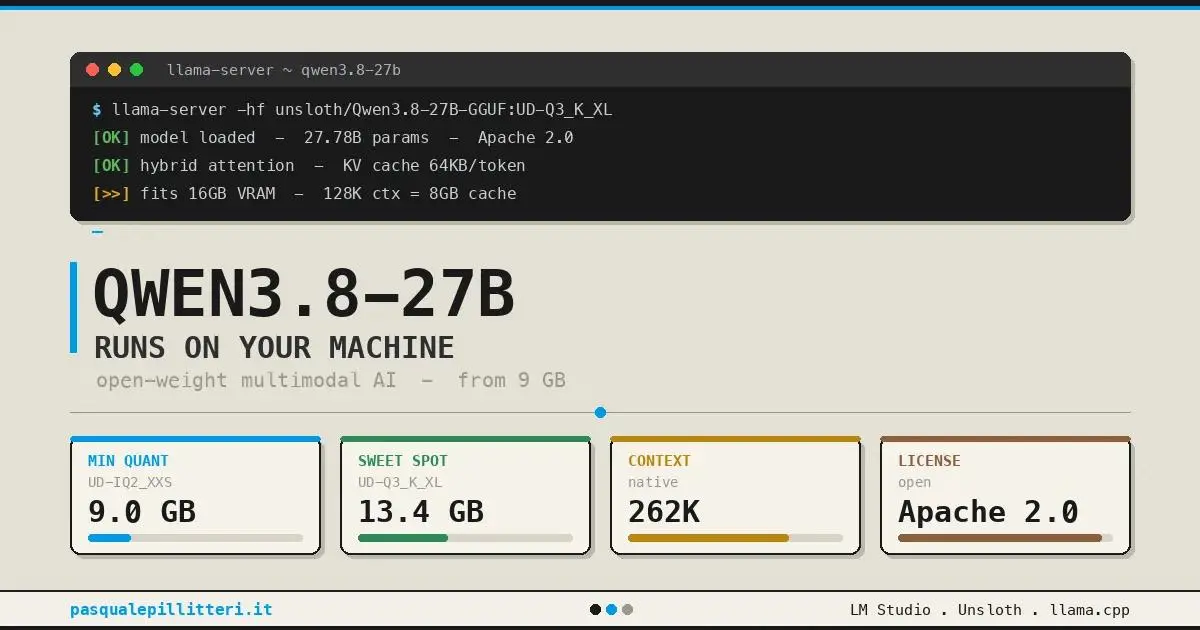
Qwen 3.8 27B یکی از مدلهای جدید خانواده Qwen است که توجه زیادی را در اجرای لوکال مدلهای زبانی جلب کرده است. مهمترین ویژگی این نسخه، ارائه یک مدل ۲۷ میلیارد پارامتری است که برخلاف مدلهای بسیار بزرگ ابری میتواند با کوانتایز مناسب روی سختافزارهای مصرفی اجرا شود. نسخه ۲۷B در حال حاضر در Ollama نیز ارائه شده و از ورودی متن و تصویر پشتیبانی میکند.
در آزمایشهای مختلف روی سختافزارهای مصرفی، Qwen 3.8 27B برای برنامهنویسی، کارهای عاملمحور و پردازش درخواستهای طولانی عملکرد قابل توجهی نشان داده است. با این حال، نتیجه واقعی به کوانتایز، مقدار VRAM، اندازه Context و نرمافزار اجرای مدل وابسته است و نمیتوان عملکرد یک سیستم را مستقیماً به سیستم دیگر تعمیم داد.
Qwen 3.8 27B چیست و چرا اجرای لوکال آن مهم است؟
Qwen 3.8 27B یک مدل Dense با حدود ۲۷ میلیارد پارامتر است. در این معماری برخلاف مدلهای Mixture of Experts تمام پارامترهای مدل در زمان پردازش فعال هستند. مدل از معماری Hybrid Attention استفاده میکند و طبق اطلاعات مدل کارت رسمی، ظرفیت Context بومی آن به ۲۶۲ هزار توکن میرسد و امکان افزایش آن تا حدود یک میلیون توکن نیز وجود دارد.
این مدل برای کارهایی مانند برنامهنویسی، پژوهش، تولید محتوا، دنبالکردن دستورهای پیچیده و اجرای وظایف عاملمحور طراحی شده است. پشتیبانی از تصویر و ویدیو نیز باعث میشود Qwen 3.8 27B فقط یک مدل متنی ساده نباشد و بتواند در سناریوهای چندرسانهای نیز استفاده شود.
اهمیت نسخه ۲۷B در این است که اجرای مدلهای بزرگ معمولاً به چندین کارت گرافیک یا سختافزار سروری نیاز دارد. در مقابل، نسخه کوانتایزشده Qwen 3.8 27B را میتوان روی کارتهایی با ۲۴ گیگابایت VRAM نیز اجرا کرد. آزمایشهای مستقل روی RTX 3090 نشان دادهاند که بسته به تنظیمات و اندازه Context میتوان این مدل را بهصورت کامل روی چنین کارتی قرار داد.
عملکرد Qwen 3.8 27B در برنامهنویسی و کارهای پیچیده
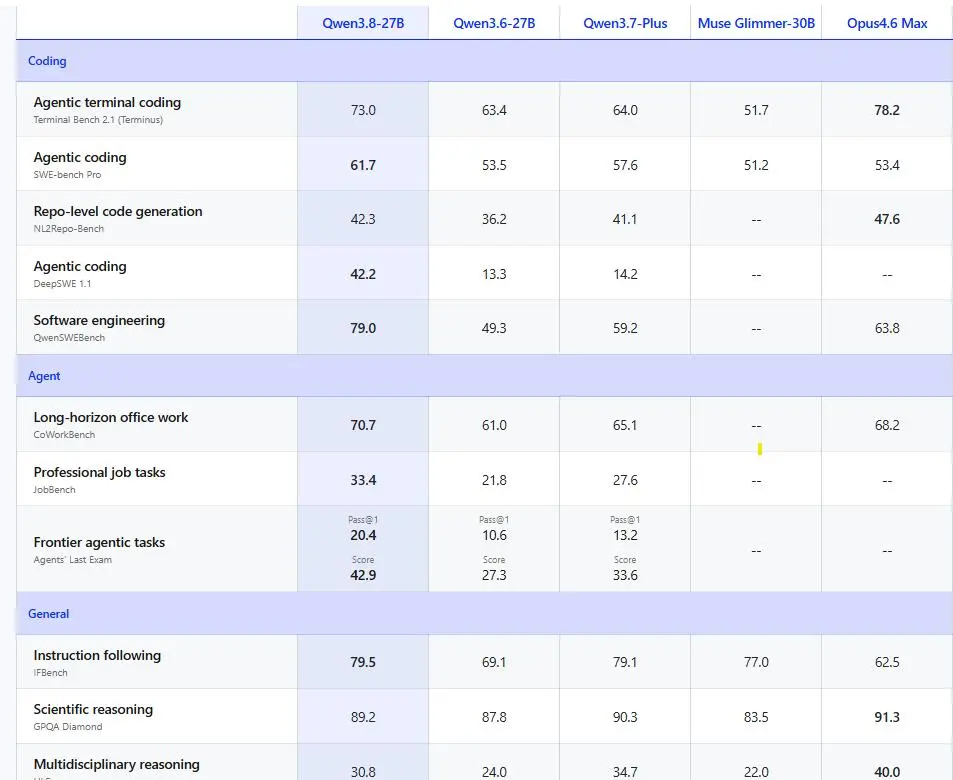
یکی از بخشهای مهم Qwen 3.8 27B عملکرد آن در برنامهنویسی و وظایف Agentic است. در نتایج منتشرشده برای مدل، امتیاز SWE-bench Pro برابر با ۶۱.۷ و امتیاز Terminal Bench 2.1 برابر با ۷۳ گزارش شده است. در LiveCodeBench v6 نیز امتیاز ۹۰.۳ ثبت شده است. این اعداد نتایج آزمایش مدل در شرایط مشخص هستند و الزاماً نشاندهنده نتیجهای یکسان روی سیستم شخصی نیستند.
در یک آزمایش عملی دیگر روی RTX 3090 نیز Qwen 3.8 27B برای اصلاح کد و اجرای یک وظیفه چندمرحلهای استفاده شده و توانسته یک پروژه واقعی را با ابزارهای محلی پردازش کند. چنین آزمایشهایی اهمیت استفاده از Harness و ابزارهای Agent را نشان میدهند زیرا کیفیت نهایی فقط به خود مدل وابسته نیست.
در آزمایشهای انجامشده روی یک سیستم مجهز به RTX 3090 نیز مدل برای ساخت یک شبیهساز فیزیک سیالات از صفر به کار گرفته شده است. نتیجه نشان میدهد مدل میتواند از مرحله تولید کد ساده فراتر برود و در پروژههایی که به چندین مرحله تولید و بررسی کد نیاز دارند نیز مورد استفاده قرار گیرد. البته محدودیت عملکرد در پروژههای سنگین همچنان وجود دارد و با افزایش پیچیدگی یا تعداد عناصر پردازشی سرعت کاهش پیدا میکند.
Qwen 3.8 27B روی RTX 3090 چقدر VRAM نیاز دارد؟
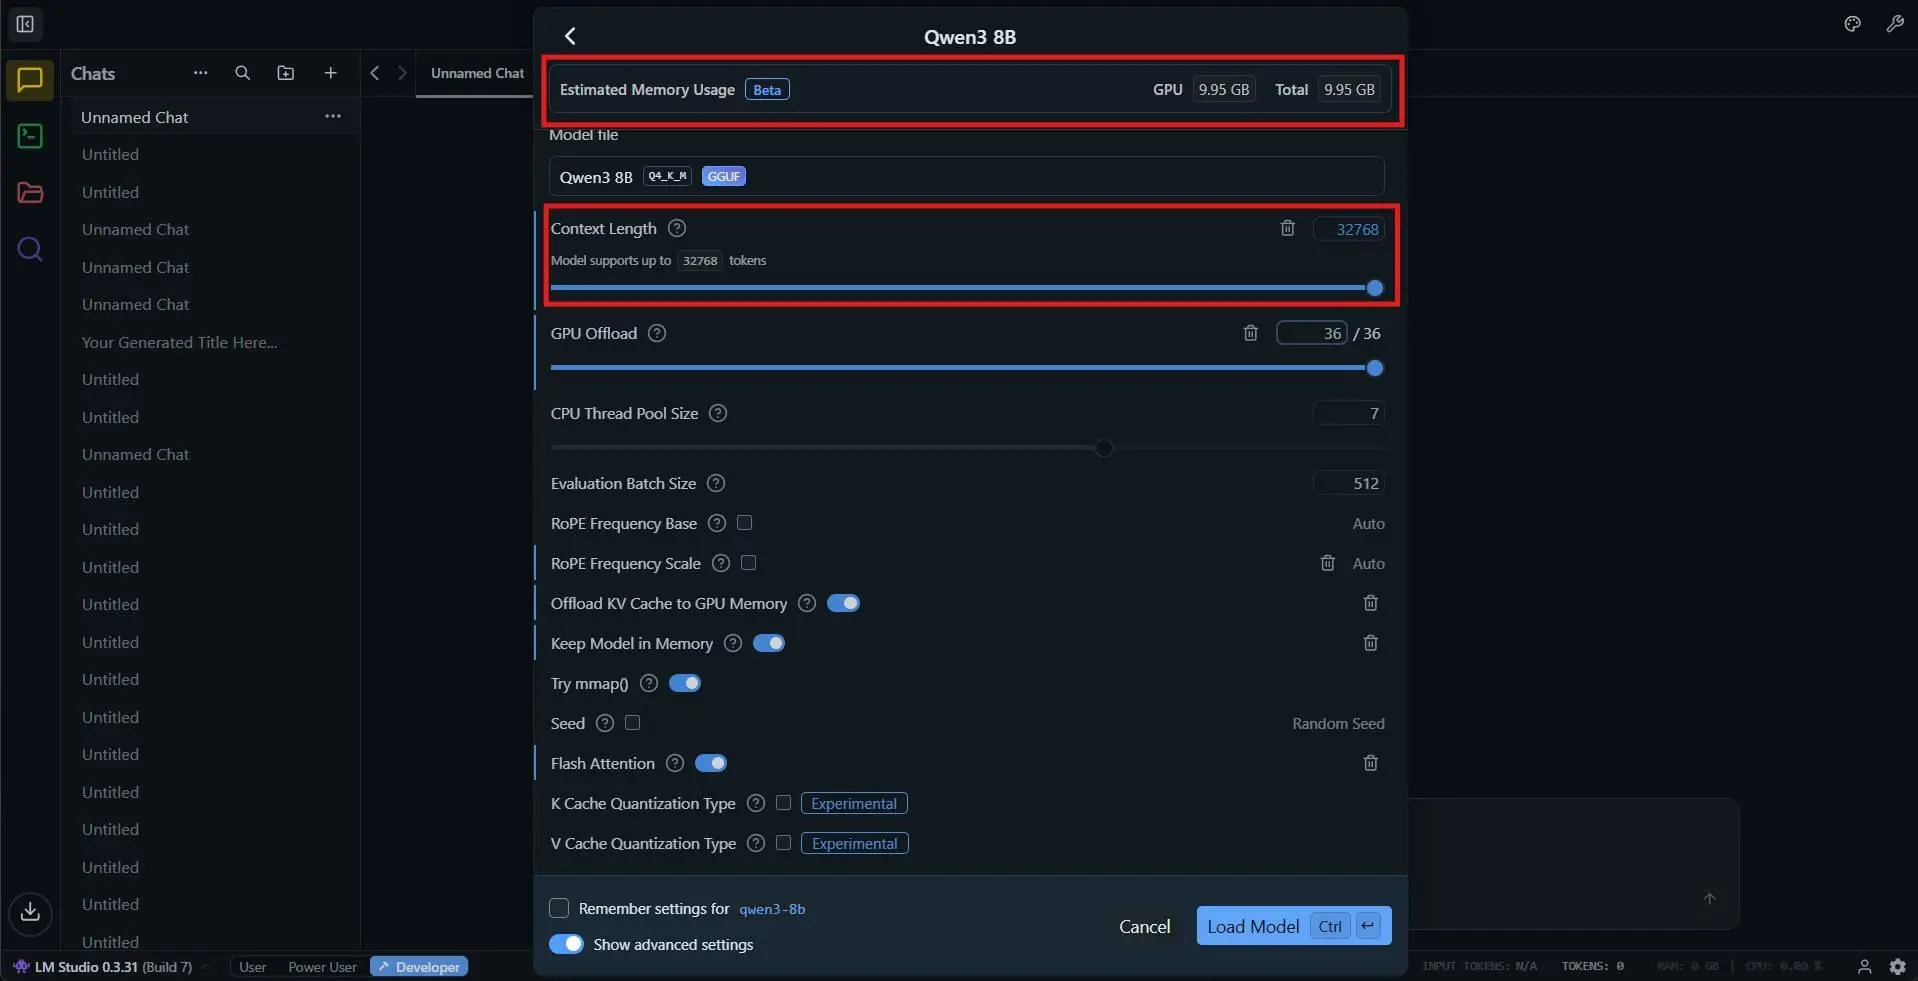
مقدار VRAM مورد نیاز فقط به تعداد پارامترهای مدل بستگی ندارد. نوع کوانتایز، اندازه Context و نوع KV Cache نیز تأثیر زیادی روی مصرف حافظه دارند. برای همین یک فایل مدل مشخص میتواند در یک سیستم با Context کوتاه بهراحتی اجرا شود اما با افزایش Context به محدودیت VRAM برسد.
در یکی از آزمایشهای منتشرشده، نسخه Q4_K_M مدل حدود ۱۶ تا ۱۸ گیگابایت فضا برای وزنهای مدل نیاز داشته است. آزمایش دیگری با نسخه UD-Q4_K_XL نیز حجم حدود ۱۷.۹ گیگابایت را نشان داده است. در نتیجه کارت ۲۴ گیگابایتی مانند RTX 3090 برای اجرای نسخههای ۴ بیتی گزینه قابل استفادهای محسوب میشود اما مقدار حافظه باقیمانده باید برای KV Cache و سایر اجزای اجرا در نظر گرفته شود.
به عنوان مثال، در یک آزمایش با Q4_K_M روی RTX 3090 مقدار مصرف VRAM با افزایش Context تا ۶۴ هزار توکن به حدود ۲۲ گیگابایت رسیده است. سرعت تولید نیز از حدود ۴۰ توکن بر ثانیه در Context کوتاه به حدود ۳۴ توکن بر ثانیه در Context ۶۴ هزار توکنی کاهش پیدا کرده است. این اعداد مربوط به همان پیکربندی آزمایشی هستند و نباید بهعنوان سرعت قطعی برای همه سیستمها در نظر گرفته شوند.
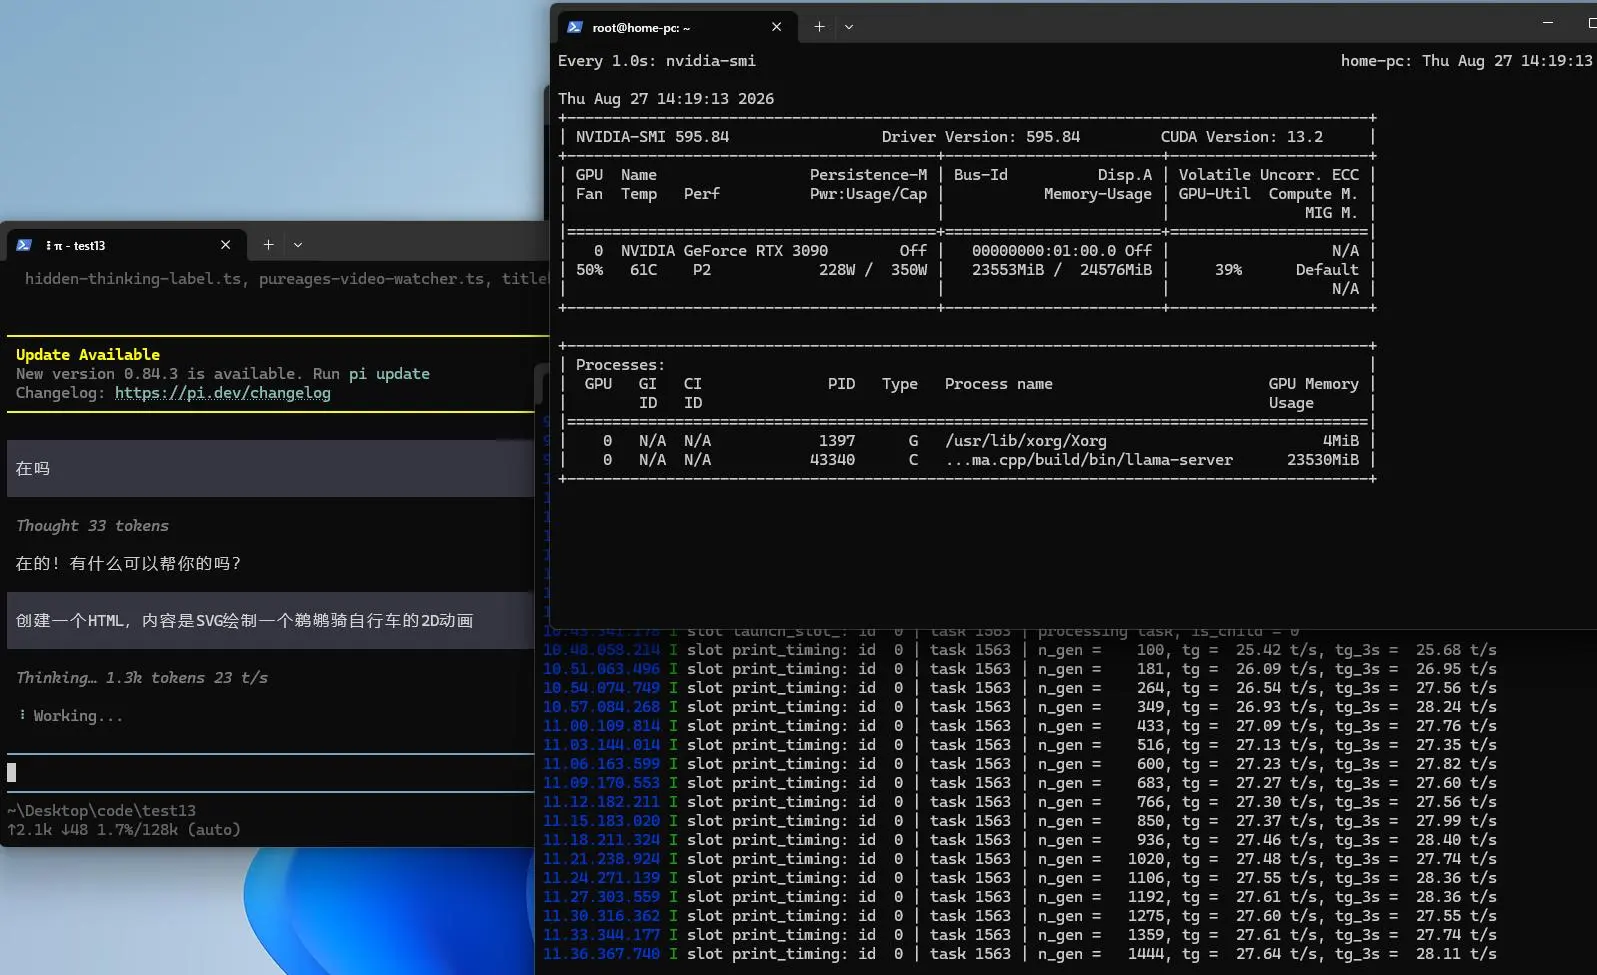
در یک آزمایش دیگر نیز نسخه Q4_K_M با Context حدود ۱۰۰ هزار توکن روی سیستم دارای ۲۴ گیگابایت VRAM اجرا شده است. این موضوع نشان میدهد که انتخاب کوانتایز مناسب و مدیریت KV Cache میتواند تفاوت بزرگی در امکان اجرای مدل ایجاد کند.
بهترین کوانتایز برای اجرای Qwen 3.8 27B چیست؟
برای کارت گرافیک ۲۴ گیگابایتی، نسخههای ۴ بیتی معمولاً نقطه تعادل مناسبی بین کیفیت و مصرف حافظه ایجاد میکنند. نسخههای با دقت بالاتر میتوانند به حافظه بیشتری نیاز داشته باشند و فضای کافی برای Context و KV Cache باقی نگذارند.
برای مثال، در یک آزمایش با Q4_K_M حدود ۱۷.۸ گیگابایت از VRAM برای خود مدل مصرف شده و با فعالکردن Context بسیار بزرگ مقدار مصرف به حدود ۲۲ گیگابایت رسیده است. بنابراین هنگام انتخاب مدل باید حجم فایل کوانتایز را بهتنهایی ملاک قرار نداد.
اجرای Qwen 3.8 27B با Ollama و ابزارهای لوکال
Ollama یکی از روشهای ساده برای اجرای Qwen 3.8 27B است. نسخه ۲۷B در مخزن رسمی Ollama با حجم حدود ۱۸ گیگابایت و Context پیشفرض ۲۵۶ هزار توکن فهرست شده است و امکان استفاده از آن در ابزارهای مختلف Agent نیز وجود دارد.
برای اجرای مدل در Ollama میتوان از دستور زیر استفاده کرد:
ollama run qwen3.8
این روش برای کسانی مناسب است که میخواهند بدون درگیرشدن با تنظیمات پیچیده سرور مدل را اجرا کنند. در مقابل، ابزارهایی مانند llama.cpp و vLLM کنترل بیشتری روی مقدار Context، نوع KV Cache، کوانتایز و بهینهسازی سرعت در اختیار کاربر قرار میدهند.
در استفاده حرفهایتر، Qwen 3.8 27B میتواند به ابزارهای Agent متصل شود. Ollama در حال حاضر برای ابزارهایی مانند Claude Code و OpenCode و چند محیط Agent دیگر دستورهای آماده ارائه کرده است. این قابلیت باعث میشود مدل محلی فقط نقش یک چتبات را نداشته باشد و بتواند در فرایندهایی مانند بررسی فایلها، اصلاح کد و اجرای وظایف چندمرحلهای نیز استفاده شود.
محدودیتهای Qwen 3.8 27B در اجرای محلی
با وجود عملکرد قابل توجه، اجرای لوکال Qwen 3.8 27B به معنی حذف کامل مزیت مدلهای ابری نیست. مهمترین محدودیت، حافظه سختافزار است. مدلهای ابری بسیار بزرگتر میتوانند از منابعی استفاده کنند که روی یک کامپیوتر شخصی در دسترس نیست.
در آزمایش مورد بررسی، نسخه Q4_K_M مدل روی کارت ۲۴ گیگابایتی حدود ۱۷.۸ گیگابایت برای وزنهای مدل مصرف کرده و همراه با Context حدود ۱۰۰ هزار توکن به حدود ۲۲ گیگابایت رسیده است. در مقابل، مدل بزرگتر Qwen 3.8 با ۲.۴ تریلیون پارامتر حتی در حالت Q4 به حافظهای در مقیاس بسیار بالاتر نیاز دارد.
Context نیز یکی دیگر از محدودیتهای مهم است. هرچه مکالمه یا پروژه طولانیتر شود، حافظه بیشتری برای نگهداری اطلاعات Context لازم است. در سیستمهای دارای VRAM محدود، کاهش Context یا استفاده از KV Cache فشردهتر میتواند به اجرای پایدارتر مدل کمک کند.
از طرف دیگر، سرعت اجرای مدل نیز ثابت نیست. نوع GPU، مقدار Context، کوانتایز، Backend و فعالبودن قابلیتهایی مانند Multi-Token Prediction میتوانند نتیجه را تغییر دهند. بنابراین اعدادی مانند ۴۰ یا ۸۰ توکن بر ثانیه فقط زمانی قابل مقایسه هستند که شرایط آزمایش تقریباً یکسان باشد. برای نمونه، آزمایشهای مختلف روی RTX 3090 سرعتهایی از حدود ۳۴ تا بیش از ۸۰ توکن بر ثانیه را با تنظیمات متفاوت گزارش کردهاند.
Qwen 3.8 27B برای چه کاربرانی مناسب است؟
Qwen 3.8 27B بیشتر برای کاربرانی جذاب است که میخواهند یک مدل نسبتاً قدرتمند را بدون ارسال دائمی اطلاعات به سرویس ابری اجرا کنند. برنامهنویسی، بررسی کد، تولید محتوا، تحلیل اسناد، کار با تصاویر و ساخت Agentهای محلی از کاربردهای مهم آن هستند.
مزیت اصلی این مدل نسبت به مدلهای بسیار بزرگ، امکان اجرای آن روی سختافزار مصرفی است. در عین حال، برای استفاده جدی باید مقدار VRAM و نوع کوانتایز را با دقت انتخاب کرد. کارت ۲۴ گیگابایتی میتواند برای نسخههای کوانتایزشده مناسب باشد اما اجرای Context بسیار بزرگ یا استفاده از دقت بالاتر ممکن است به حافظه بیشتری نیاز داشته باشد.
نتایج رسمی Qwen 3.8 27B نیز نشان میدهد تمرکز این مدل فقط روی پاسخهای معمولی چت نیست و بخش مهمی از توسعه آن به برنامهنویسی و وظایف Agentic اختصاص داشته است. برای همین، در صورتی که هدف اصلی اجرای لوکال برای برنامهنویسی باشد، قابلیتهای آن اهمیت بیشتری از صرفاً تعداد پارامترها پیدا میکند.
در مجموع، Qwen 3.8 27B نشان میدهد فاصله میان مدلهای قابل اجرای محلی و مدلهای بسیار بزرگ ابری در برخی کاربردها کمتر شده است. با این حال، مقایسه منصفانه باید با درنظرگرفتن سختافزار، کوانتایز، Context و ابزار اجرای مدل انجام شود و نتایج یک آزمایش منفرد نباید به همه کاربران تعمیم داده شود.
سیارهی آیتی