کمبود حافظه گرافیکی یا VRAM همیشه به این معنی نیست که نمیتوانید مدلهای بزرگ هوش مصنوعی را روی کامپیوتر شخصی اجرا کنید. با استفاده از ابزار llama.cpp و تنظیم نحوه استفاده از حافظه کارت گرافیک و رم سیستم، در برخی شرایط میتوان مدلهایی را اجرا کرد که حجم فایل آنها از ظرفیت VRAM بیشتر است. این روش بهویژه برای اجرای محلی هوش مصنوعی روی لپتاپهای مجهز به کارت گرافیک ۸ گیگابایتی کاربرد دارد.
چگونه مدلهای بزرگ هوش مصنوعی را با VRAM کم اجرا کنیم؟
یکی از راهکارهای کاربردی، استفاده از قابلیت انتقال بخشی از وزنهای مدل به رم سیستم است. در اجرای محلی مدلهای زبانی، همه بخشهای مدل الزاماً به یک شکل از پردازنده گرافیکی استفاده نمیکنند. بنابراین، بسته به معماری مدل میتوان بخشی از دادهها را در رم نگه داشت و فضای VRAM را برای قسمتهای حساس به سرعت آزاد کرد.
نکته مهم این است که بزرگتر بودن مدل بهتنهایی تعیین نمیکند که اجرای آن چقدر سریع خواهد بود. نوع معماری مدل، میزان کوانتایز، ظرفیت رم، پهنای باند حافظه و تنظیمات نرمافزار نیز بر سرعت پاسخگویی تأثیر میگذارند. به همین دلیل، با انتخاب تنظیمات مناسب میتوان از سختافزار موجود بهتر استفاده کرد، هرچند اجرای همه مدلها روی هر سیستمی امکانپذیر نیست.
این روش در مدلهای Mixture of Experts یا MoE اهمیت بیشتری دارد. در این معماری، مدل از چندین بخش تخصصی تشکیل شده است، اما برای تولید هر پاسخ فقط تعدادی از این بخشها فعال میشوند. به همین دلیل، حجم کلی مدل لزوماً نشاندهنده مقدار محاسباتی نیست که برای هر توکن انجام میشود.
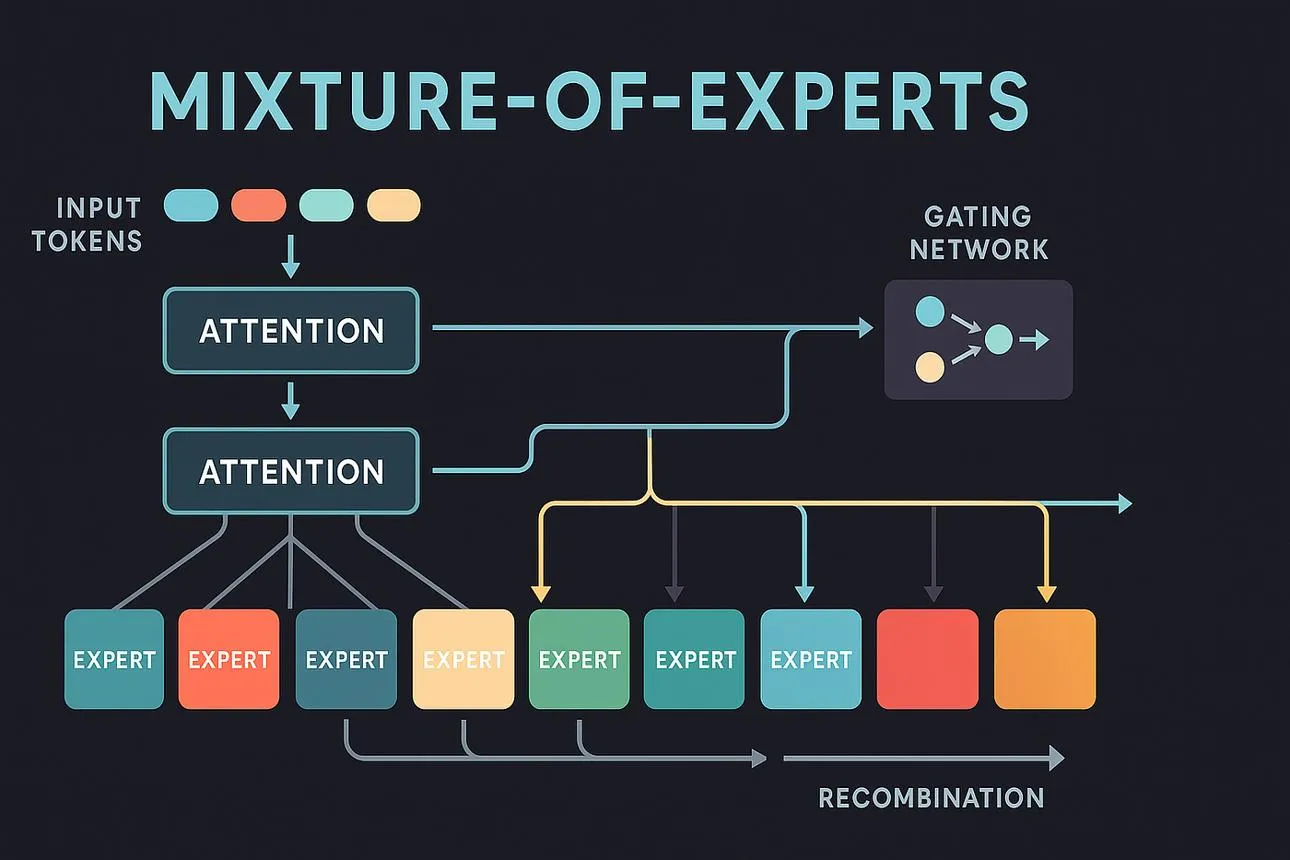
در مقابل، مدلهای متراکم یا Dense معمولاً به شکل متفاوتی از وزنهای خود استفاده میکنند و انتقال وزنها به رم همیشه همان مزیت را ایجاد نمیکند. در نتیجه، پیش از انتخاب مدل باید نوع معماری آن را بررسی کنید.
اجرای مدلهای MoE با llama.cpp و انتقال وزنها به رم
ابزار llama.cpp امکان کنترل نحوه بارگذاری مدل روی GPU و نگهداری وزنهای متخصص مدلهای MoE در حافظه سیستم را فراهم میکند. دو پارامتر مهم برای این کار عبارتاند از:
- -ngl 99 برای درخواست بارگذاری حداکثر لایههای ممکن روی GPU؛ مقدار ۹۹ به معنی تضمین قرارگرفتن تمام دادهها در VRAM نیست.
- --n-cpu-moe N برای نگهداشتن وزنهای بخش متخصص در تعداد مشخصی از لایههای ابتدایی مدل در حافظه CPU بهجای GPU.
برای مثال، مقدار --n-cpu-moe 28 وزنهای متخصص ۲۸ لایه ابتدایی را در حافظه سیستم نگه میدارد. این کار میتواند مصرف VRAM را کاهش دهد، اما بخشی از پردازش به حافظه سیستم وابسته میشود و نتیجه نهایی به مدل و سختافزار بستگی دارد. نام و پشتیبانی دقیق پارامترها نیز ممکن است با نسخه llama.cpp تغییر کند.
چگونه سرعت اجرای مدل هوش مصنوعی را اندازهگیری کنیم؟
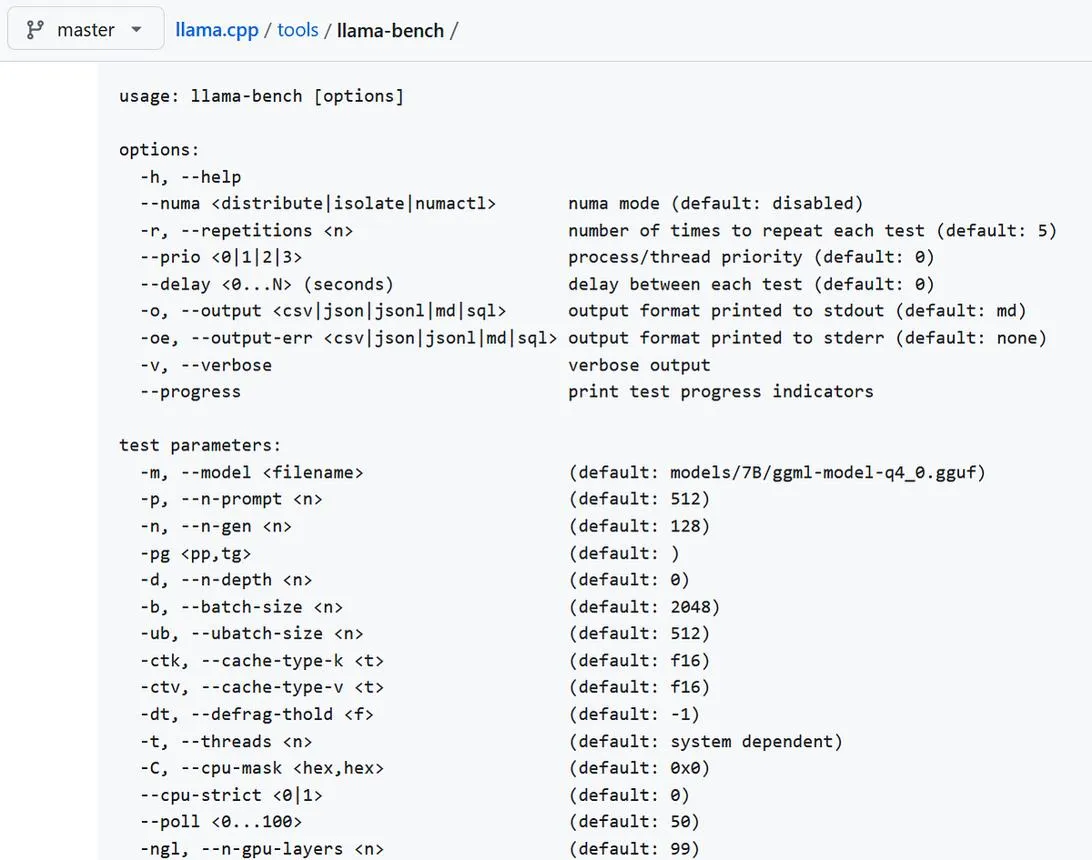
برای مقایسه تنظیمات، ابزار llama-bench در مجموعه llama.cpp امکان اندازهگیری سرعت پردازش ورودی و تولید توکن را فراهم میکند. بهتر است هر پیکربندی چند بار آزمایش شود تا نتیجه به یک اجرای اتفاقی وابسته نباشد.
در ویندوز، اگر فایل اجرایی و مدلها در فولدر فعلی قرار دارند، میتوانید از خط فرمان برای اجرای بنچمارک استفاده کنید. نمونه زیر برای مقایسه دو مدل و دو مقدار متفاوت انتقال وزنهای متخصص نوشته شده است؛ نام فایلها را با فایلهای موجود در سیستم خودتان جایگزین کنید:
.llama-bench.exe -m model-dense.gguf -m model-moe.gguf -ngl 99 -ncmoe 0,28 -p 512 -n 128 -r 3 -ctk q8_0 -ctv q8_0
این دستور چند ترکیب از مدلها و تنظیمات را آزمایش میکند. پارامتر -p 512 تعداد توکنهای ورودی آزمایشی و -n 128 تعداد توکنهای تولیدی را تعیین میکند. گزینه -r 3 هر آزمون را سه بار تکرار میکند و -ctk q8_0 و -ctv q8_0 نوع داده کش کلید و مقدار را مشخص میکنند. پشتیبانی از گزینهها و ترکیب آنها را با نسخه نصبشده بررسی کنید.
آیا کارت گرافیک ۸ گیگابایتی برای اجرای مدل ۳۵ میلیارد پارامتری کافی است؟
در یک آزمایش، مدل MoE با ۳۵ میلیارد پارامتر روی لپتاپی با کارت گرافیک RTX 3070 و حافظه ۸ گیگابایتی بررسی شد. با انتقال وزنهای متخصص ۲۸ لایه به رم سیستم، سرعت تولید گزارششده از حدود ۴ به حدود ۳۳ توکن در ثانیه رسید. این نتیجه مربوط به همان مدل، نسخه نرمافزار و تنظیمات آزمایش است و نباید آن را سرعت تضمینشده برای همه سیستمها دانست.
برای دستیابی به نتیجه مناسب، چند عامل را در نظر بگیرید:
- رم سیستم: برای نگهداری بخشهایی از مدل که روی GPU قرار نمیگیرند، به رم کافی نیاز دارید.
- کوانتایز مدل: نسخههای کوانتایزشده معمولاً فضای کمتری اشغال میکنند، اما میزان کاهش کیفیت و سرعت به روش کوانتایز بستگی دارد.
- طول کانتکست: افزایش طول متن قابل پردازش، مصرف حافظه کش را بیشتر میکند.
- سرعت حافظه و پردازنده: انتقال داده بین رم و GPU میتواند به گلوگاه عملکرد تبدیل شود.
- نوع مدل: انتقال وزنهای متخصص در مدلهای MoE ممکن است مفید باشد، اما همین روش برای مدلهای Dense الزاماً نتیجه مشابهی ندارد.
در مجموع، اجرای محلی مدلهای بزرگ هوش مصنوعی روی کامپیوترهای دارای VRAM محدود امکانپذیر است، اما انتخاب مدل و تنظیمات اهمیت زیادی دارد. بهتر است با یک مدل کوانتایزشده مناسب شروع کنید، مقدار انتقال وزنها به رم را تغییر دهید و با بنچمارک، سرعت تولید و مصرف حافظه را در سیستم خودتان بسنجید.
سیارهی آیتی